NewsWhip 的新 AI 情感分析功能向传播团队提出了一个实际问题:当仪表盘把报道标为负面时,下一步应该做什么?有效的回答应从文章、报道对象及其语境出发,再判断该问题需要调查、回应,还是继续观察。标签能够帮助组织这些工作,却无法独立完成判断。
这次发布为团队完善声誉仪表盘背后的证据提供了契机,但不足以证明品牌声誉已经改变。本文先概述经过核实的发布信息,再提出独立的评估方法。下文的测试、计算和运营做法均为原创编辑分析,并非对 NewsWhip 内部模型的描述,也不是对其性能的保证。
11 月 10 日公布了什么
Sprout Social 于 2026 年 11 月 10 日宣布在 NewsWhip 中推出 AI Sentiment Analysis。公司表示,该功能会评估整篇文章的语境,并将报道对某一品牌的情感归为正面、负面或中性。团队可以创建自定义 Analyzers,设置品牌信息追踪标准。指标关联原始文章及驱动因素摘要,公告称该功能已在面向品牌客户的 NewsWhip 仪表盘中提供。来源:Sprout Social 公告。
公告没有提供独立的准确性基准、错误率、针对具体语言的验证,或关于声誉变化的因果研究。阿拉伯语支持、价格及具体套餐资格也未得到核实。决定哪些流程值得信任、哪些需要追加测试时,这些空白很重要。某项功能出现在仪表盘上,不代表它已被证实适合所有语言、市场或敏感用途。
区分四类不同的证据
首先建立四阶段图景:已发布内容、受众接触、受众理解,以及之后的信任或行为。文章层面的情感标签涉及第一阶段。即使标签完全正确,也不能说明多少相关受众看过文章、他们是否按品牌期望理解文章,或者文章是否影响了后续决定。每一项关于后续阶段的主张,都需要与之匹配的证据。
例如,一篇文章可能批评某种行业做法,同时肯定一家公司的纠正措施。读者可能记住批评、纠正措施,或两者都没记住。监测团队在推断可能影响之前,应先确定文章究竟如何描述被提及的品牌。当同一报道涉及多家公司,或某段引语来自对立一方时,这一区分尤其重要。
报告中应使用独立字段,而不是把所有内容混合成一个声誉分数。分别记录内容评估、可获得的传播证据、受众研究和观察到的业务信号,并明确标注未知项。接触情况字段留空,比默默把潜在触达当作实际阅读更加诚实,也更有用。这样,管理者才能看清哪些结论有依据,哪些仍是需要调查的假设。
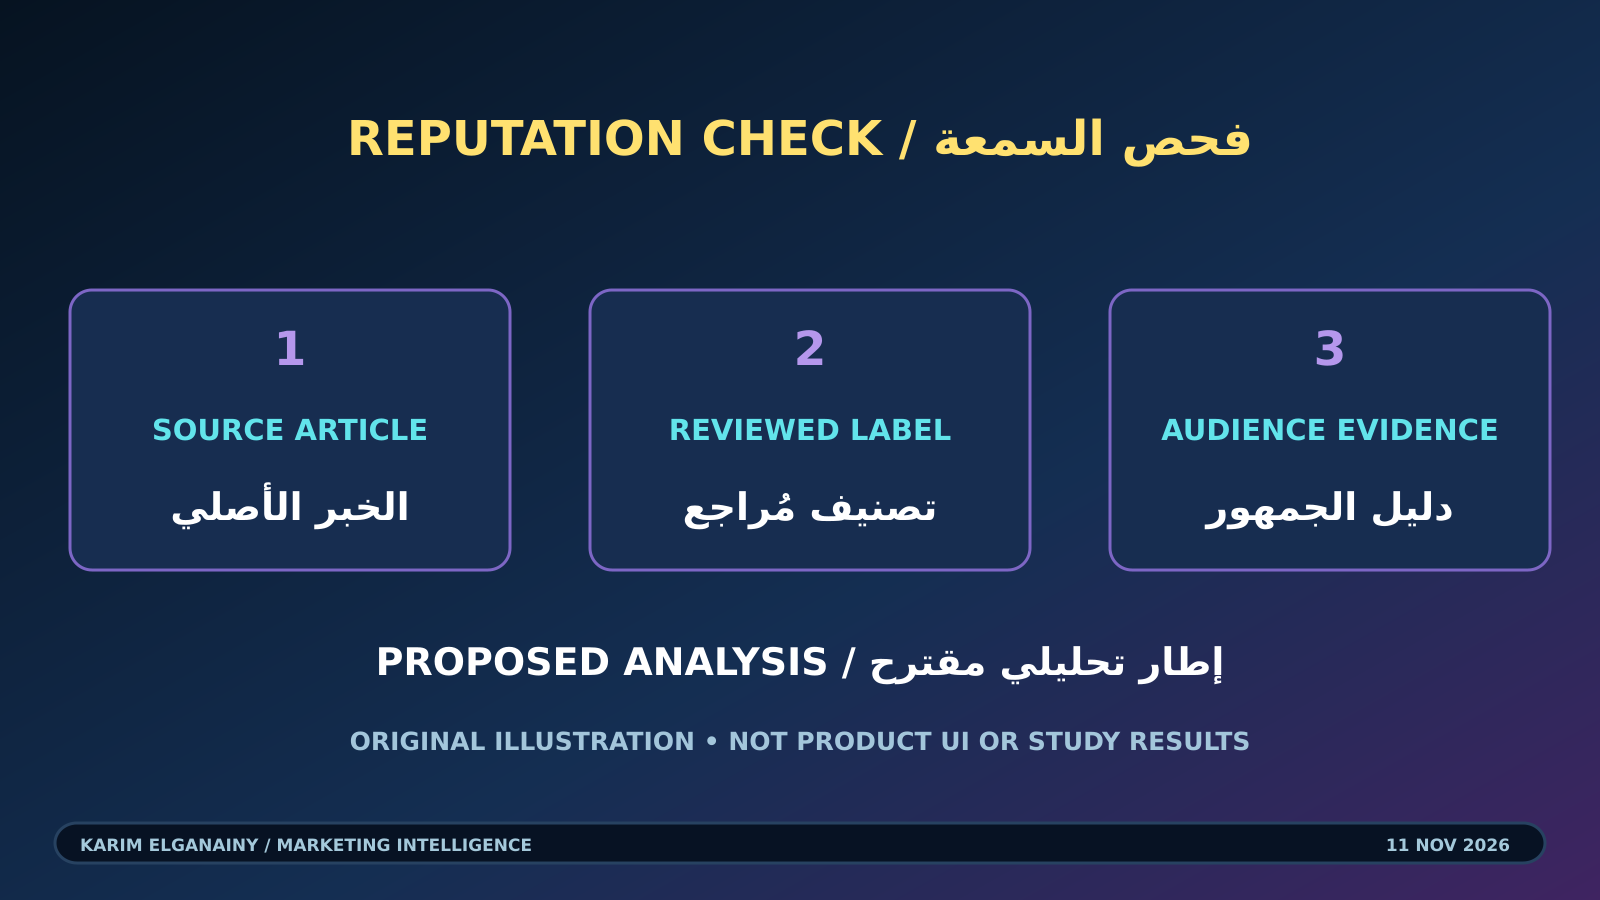
原创插图:Karim Elganainy。本分析的原创概念图分为原始文章、经审核的标签和受众证据三个独立板块,说明报道评估只是更广泛声誉调查的一项输入。图中使用阿拉伯语和英语标签,其含义由周围的本地化文字解释。这不是 NewsWhip 界面、其技术架构,也不是受众影响的证明。 来源背景:公告.
计算趋势前先定义计量单位
先就仪表盘中的一个条目如何定义达成一致。原创报道、转载副本、后续更新和链接到报道的社交帖子,可能描述同一事件,却触及不同读者。若将它们全部视为独立的编辑判断,就可能夸大问题的广泛程度;若删除所有副本,又可能丢失有用的传播信息。因此,应将原创报道数量与传播数量分开。
明确时间窗口及修订处理方式。早期文章中的某项指控可能在之后得到更正。团队需要明确规则,以保存原始评估、存储更新版本,并解释趋势为何变化。否则,昨天的报告可能悄然改变,使团队难以还原当时为何作出某个决定。这是一项报告设计建议,并非对产品功能的描述。
始终展示分母。一个假设案例是:负面文章由 100 篇中的 10 篇变为 400 篇中的 20 篇,负面数量翻倍,但占比从 10% 降至 5%。任何一个视角都不能独立描述声誉。应同时报告数量、占比和报道总量变化,再检查主题、媒体或市场构成是否改变。这只是算术示例,不是 NewsWhip 客户的结果。
建立包含困难案例的审核样本
用接近机构真实监测任务的报道建立参考集。纳入日常中性报道、褒贬混合评价、对竞争对手的批评、引语、反讽、品牌名称歧义,以及标题与正文不同的文章。对重要语言和市场分别抽样。若样本只包含明确赞扬和明显批评,几乎任何评估都会显得比实际运营使用容易。
在审核者看到自动结果之前,编写简短的标注指南。说明目标品牌、相关段落、各类别含义,以及语境不足时如何处理。请两位审核者独立评估同一份样本,再通过讨论证据解决分歧,同时保留最初判断。人工分歧可能暴露的是定义模糊,而不是模型缺陷,因此不要把不确定性伪装成确定结论。
调整标准后,使用单独保留的数据集进行最终检查。反复根据同一批例子修改规则,会让流程看似可靠,却不能证明它适用于新情况。记录例子的选择方式,以及尚未解决的困难案例。多语言审核需要熟悉相关语言和语境的人员;把所有内容译成一种语言,可能恰恰消除团队需要检验的歧义。
关注后果重大的错误,而不只是平均一致率
单一的总体一致率把所有不匹配视为同等重要。然而,在运营中,漏掉严重指控与把普通行业更新标为警报,可能产生不同后果。应分别检查这些错误类型,判断紧急警报通常是否相关,以及重要事件是否被遗漏。可接受的表现应根据所支持的决策预先确定,而不是看到结果后再选择一个有利的平均值。
考虑一个明确假设的审核集,其中有 20 条真正紧急的信息。假如系统识别出其中 15 条,同时把 15 条非紧急信息也标为警报,就会产生 30 条警报。一半警报相关,系统识别出 75% 的紧急信息,另有 5 条紧急信息被遗漏。这些数字回答不同的问题:多少审核精力被浪费,以及多少重要报道没有进入警报队列。
该例评估的是紧急程度,它是不同于正面、负面或中性情感的另一种编辑分类,不应被描述成 NewsWhip 的内置指标。负面餐厅评论与有证据支持的安全指控,都可能呈现负面情感,却需要截然不同的回应。应区分文章所表达的内容、问题的严重程度,以及机构准备采取的行动。
为每次升级处理保留证据链
升级处理时,应提供相关文章、涉及品牌的具体段落、问题为何重要、尚未解决的问题,以及负责决定下一步的人。不要只发送彩色标识或百分比变化。接收者应能理解问题,而不必重新完成监测团队的工作。来源链接之所以有用,是因为它们支持核查,前提是审核者确实阅读了底层材料。
选择与证据相符的行动。有些事项需要向内部负责人核实事实;另一些适合继续监测新信息,或按已批准的流程纠正不准确陈述。公开回应是一项独立的传播决策,并非负面标签的自动结果。审核应考虑回应能否澄清情况、是否会引来不必要的关注,或是否会作出机构目前无法支持的主张。
记录决定及其理由,包括选择不采取公开行动。后续复盘便能区分遗漏信号与经过充分考虑的主动决定。内部评估的访问范围应与其敏感程度匹配,避免收集与问题无关的作者或读者个人信息。有用的审计记录应记录问题与决策,不必变成对所有相关人员的无限制档案。
让多语言验证扎根当地语境
对于同时监测阿拉伯语和英语的团队,首先要确认实际产品配置是否支持目标语言和报道来源。所审核的公告未能证实这一点。依赖该功能之前,应向供应商索取最新文档并测试对应流程。翻译后的界面、翻译后的文章,以及在原语言报道上接受评估的模型,是三种不同的支持形式。
准备能够反映本地报道如何表达批评、赞扬、不确定性和引述归属的案例。同一句话可能因为媒体、方言、引号或上下文论证不同而具有不同力度。审核者应以清楚的语言解释自己的理解,并指出支持该判断的段落。另一种语言的类别分布与英语仪表盘相似,并不能证明两者性能相当。
样本允许时,应按语言和案例类型报告质量。如果已审核条目太少,无法得出有用结论,就直接说明。小规模试点可能发现失效模式,却无法估计稳定错误率,必须区分这两类发现。当管理层希望得到一个全球分数时,这点尤其重要:合并平均值可能掩盖某个本应得到单独关注的市场中的薄弱流程。
声称声誉改变之前,补充受众证据
报道分析可以帮助选择受众研究的问题,指出哪些主张值得检验、哪些群体可能相关,但研究设计仍须确定人们接触过什么,以及他们相信什么。追踪变化时,应使用一致的问题和可比较的样本。解释时间、招募方式或市场构成上的差异如何影响比较,而不是把所有变化都归因于被监测的报道。
经过核实的客户反馈可以补充有用背景,尤其是客户明确提到相关事件时。但应区分少量有信息价值的评论和具有代表性的估计。服务投诉、购买变化和品牌调查可以分别揭示问题的不同部分,不能仅因为它们在同一周发生变化,就把它们合并成同一个因果故事。其他事件也可能解释部分或全部变化。
因此,一份站得住脚的管理层摘要可以保持克制,同时具有行动价值:某一问题的报道增加;已审核文章支持一项具体担忧;受众影响仍不确定;团队正在核实一个明确问题。这既提供行动依据,也不会夸大认知。如果后续研究支持更强结论,就更新评估并保留早期的不确定性,而不是重写决策历史。
进行有边界的试点,确定可以信任什么
从明确的品牌、市场、来源和决策范围开始。记录现有人工工作量,选定审核样本,明确升级处理负责人,并规定何种情况需要暂停试点。衡量的是作出有依据决定所需的时间,而不只是分类节省的时间。如果审核者必须花更多时间纠正误导性警报或寻找相关段落,分类变快的价值就很有限。
试点结束时,应区分证据能够支持的决策。某流程可能适合整理日常阅读清单,却不适合自动触发危机升级;它可能在一种语言中表现足够好,在其他语言中仍需额外审核。记录这些边界,并在来源构成、标注标准或产品变化时重新检查。信任应建立在经过测试的用例上,而不是笼统宣称 AI 理解声誉。
NewsWhip 此次公告的实际价值,在于让报道评估有机会变得更容易核查、更有用。团队应以自己审核过的案例和运营结果判断这个机会。让文章标签紧贴其证据,让行动责任保持明确,并只在有相应受众证据时作出声誉方面的结论。
评论
暂无已发布的评论。