La nuova funzione di sentiment AI di NewsWhip pone una domanda pratica ai team di comunicazione: quando una dashboard definisce negativa una copertura, quale decisione deve seguire? Una risposta utile parte dall’articolo, dal soggetto di cui parla e dal contesto. Poi valuta se la questione richiede un’indagine, una risposta o ulteriore osservazione. L’etichetta può aiutare a organizzare il lavoro, ma non può completare da sola il giudizio.
L’annuncio offre un motivo per migliorare le prove alla base di una dashboard reputazionale. Non basta a dimostrare che la reputazione di un brand sia cambiata. Questo articolo riassume prima i fatti verificati del lancio, poi sviluppa un metodo di valutazione indipendente. Test, calcoli e pratiche operative proposti di seguito sono analisi editoriale originale, non descrizioni del modello interno di NewsWhip né garanzie delle sue prestazioni.
Che cosa è stato annunciato il 10 novembre
Sprout Social ha annunciato AI Sentiment Analysis all’interno di NewsWhip il 10 novembre 2026. Secondo l’azienda, la funzione valuta il contesto dell’intero articolo e classifica la copertura come positiva, negativa o neutra per un brand. I team possono creare Analyzers personalizzati con criteri per monitorare i messaggi del brand. Le metriche rimandano agli articoli originali e ai riepiloghi dei fattori rilevanti; l’annuncio indica la disponibilità nelle dashboard NewsWhip per i clienti brand. Fonte: annuncio Sprout Social.
Il comunicato non fornisce benchmark indipendenti di accuratezza, tassi di errore, verifiche per singola lingua o studi causali sui cambiamenti reputazionali. Non sono stati verificati il supporto per l’arabo, i prezzi e l’idoneità precisa dei piani. Queste lacune contano nel decidere quali processi considerare affidabili e quali testare ulteriormente. La presenza in una dashboard non dimostra l’idoneità per ogni lingua, mercato o impiego sensibile.
Separare quattro tipi diversi di prove
Si parte da una mappa in quattro fasi: contenuto pubblicato, esposizione del pubblico, interpretazione del pubblico e successiva fiducia o comportamento. Un’etichetta di sentiment a livello di articolo riguarda la prima fase. Anche un’etichetta completamente corretta non stabilisce quante persone rilevanti abbiano visto l’articolo, se lo abbiano interpretato come previsto dal brand o se abbia influenzato una decisione successiva. Ogni affermazione sulle fasi seguenti richiede prove adeguate.
Un articolo, per esempio, potrebbe criticare una pratica di settore e descrivere favorevolmente l’azione correttiva di un’azienda. Un lettore potrebbe ricordare la critica, la correzione o nessuna delle due. Il team di monitoraggio dovrebbe identificare ciò che l’articolo dice effettivamente del brand citato prima di trarre conclusioni sul possibile effetto. La distinzione è particolarmente importante quando compaiono più aziende o una citazione è attribuita alla controparte.
Nei report si usino campi separati, anziché un unico numero reputazionale aggregato. Registrare la valutazione del contenuto, le prove disponibili sulla distribuzione, eventuali ricerche sul pubblico e i segnali aziendali osservati. Indicare esplicitamente ciò che non si conosce. Un campo sull’esposizione vuoto è più onesto e utile dell’equiparare implicitamente la copertura potenziale a letture effettive. Questa separazione mostra ai responsabili quali conclusioni sono fondate e quali restano ipotesi da approfondire.
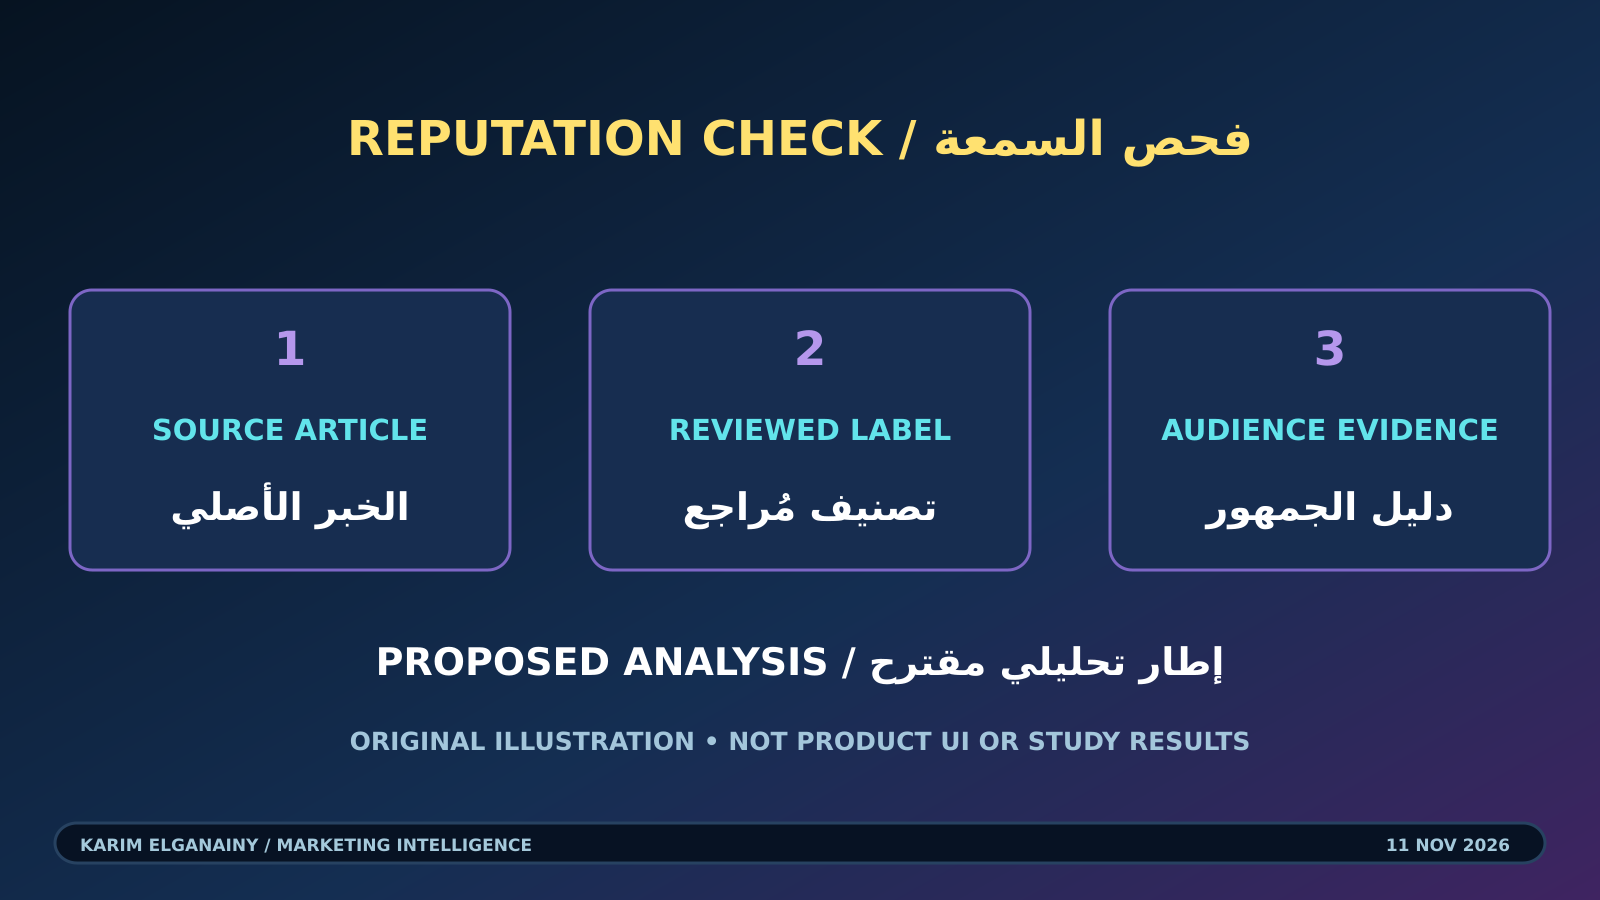
Illustrazione originale di Karim Elganainy. Illustrazione concettuale originale per questa analisi: articolo originale, etichetta verificata e prove sul pubblico sono tre pannelli distinti. Mostrano che la valutazione della copertura è un input di un’indagine reputazionale più ampia. Il disegno contiene etichette arabe e inglesi, spiegate nel testo localizzato circostante. Non è un’interfaccia NewsWhip, la sua architettura tecnica o una prova dell’impatto sul pubblico. Contesto della fonte: annuncio.
Definire l’unità prima di calcolare una tendenza
Concordare che cosa costituisce un singolo elemento nella dashboard. Un servizio originale, una copia ripubblicata, un aggiornamento e un post sociale che rimanda al servizio possono descrivere lo stesso evento raggiungendo lettori diversi. Contarli tutti come giudizi editoriali indipendenti può esagerare l’ampiezza apparente della questione. Eliminare tutte le copie può invece cancellare informazioni utili sulla distribuzione. Occorre distinguere il conteggio delle storie originali da quello della distribuzione.
Definire la finestra temporale e il trattamento delle revisioni. Un primo articolo può contenere un’accusa corretta successivamente. Serve una regola chiara per conservare la valutazione originale, archiviare la versione aggiornata e spiegare ogni variazione nella tendenza. Altrimenti il report di ieri potrebbe cambiare senza che sia visibile, rendendo difficile ricostruire perché una decisione fu presa in quel momento. È una raccomandazione di progettazione dei report, non una funzione attribuita al prodotto.
Mantenere visibile il denominatore. Un passaggio ipotetico da 10 articoli negativi su 100 a 20 su 400 raddoppia il numero negativo, ma ne riduce la quota dal 10% al 5%. Nessuna delle due prospettive descrive da sola la reputazione. Riportare insieme quantità, quote e variazione della copertura totale, poi verificare se sia cambiato il mix di argomenti, testate o mercati. È un esempio aritmetico, non un risultato di un cliente NewsWhip.
Costruire un campione con casi difficili
Creare un insieme di riferimento da una copertura simile al reale lavoro di monitoraggio dell’organizzazione. Includere normali notizie neutrali, valutazioni miste, critiche ai concorrenti, citazioni, ironia, ambiguità nei nomi e articoli con titoli diversi dal contenuto. Campionare separatamente lingue e mercati importanti. Una raccolta composta soltanto da elogi chiari e critiche evidenti farà sembrare quasi ogni valutazione più facile dell’uso operativo reale.
Scrivere una breve guida di classificazione prima che i revisori vedano il risultato automatico. Indicare il brand interessato, il passaggio rilevante, il significato di ogni categoria e come gestire un contesto insufficiente. Chiedere a due revisori di valutare indipendentemente lo stesso campione. Conciliare le divergenze discutendo le prove e conservando i giudizi iniziali. Il disaccordo umano può rivelare una definizione vaga anziché un difetto del modello: non va trasformato in certezza artificiale.
Riservare un insieme separato per la verifica finale dopo avere affinato i criteri. Modificare ripetutamente le regole sugli stessi esempi può far apparire affidabile un processo senza dimostrarne la generalizzabilità. Documentare come sono stati selezionati gli esempi e quali casi difficili rimangono irrisolti. Per la revisione multilingue servono persone che comprendano lingua e contesto: tradurre tutto in una sola lingua può eliminare proprio l’ambiguità da verificare.
Esaminare gli errori importanti, non solo l’accordo medio
Un unico tasso di accordo complessivo considera tutte le divergenze ugualmente importanti. Operativamente, perdere un’accusa grave e segnalare un innocuo aggiornamento di settore possono avere conseguenze diverse. Esaminare questi errori separatamente. Chiedersi se gli avvisi urgenti siano generalmente pertinenti e se vengano persi casi importanti. Stabilire le prestazioni accettabili in base alla decisione supportata, invece di scegliere una media favorevole dopo aver visto i risultati.
Si consideri un insieme di revisione chiaramente ipotetico con 20 elementi davvero urgenti. Se il sistema ne segnala 15 e segnala anche 15 elementi non urgenti, produce 30 avvisi. Metà degli avvisi è pertinente e viene identificato il 75% degli elementi urgenti. Cinque elementi urgenti restano esclusi. Queste cifre rispondono a domande diverse: quanto lavoro di revisione viene sprecato e quanta copertura importante sfugge alla coda degli avvisi.
L’esempio valuta l’urgenza, una classificazione editoriale distinta dal sentiment positivo, negativo o neutro. Non va presentata come una metrica integrata in NewsWhip. Una recensione negativa di un ristorante e un’accusa documentata sulla sicurezza potrebbero entrambe esprimere sentiment negativo, ma richiedere risposte molto diverse. Mantenere distinta la descrizione dell’articolo dalla gravità della questione e dall’azione che l’organizzazione è pronta a intraprendere.
Dare a ogni escalation una traccia delle prove
Un’escalation dovrebbe includere l’articolo pertinente, il passaggio relativo al brand, il motivo della sua importanza, le domande aperte e la persona responsabile del passo successivo. Evitare di inviare soltanto un simbolo colorato o una variazione percentuale. Il destinatario deve capire la questione senza ricostruire il lavoro del team di monitoraggio. I collegamenti alle fonti rendono possibile questa verifica, purché i revisori leggano davvero il materiale sottostante.
Scegliere azioni coerenti con le prove. Alcuni elementi richiedono una verifica fattuale con un responsabile interno. Altri giustificano il monitoraggio di nuove informazioni o la correzione di un’affermazione inesatta attraverso una procedura approvata. La risposta pubblica è una decisione di comunicazione separata, non una conseguenza automatica dell’etichetta negativa. Valutare se chiarirebbe la situazione, attirerebbe attenzione inutile o introdurrebbe un’affermazione che l’organizzazione non può ancora sostenere.
Registrare la decisione e la motivazione, compresa la scelta di non intervenire pubblicamente. La revisione successiva potrà distinguere un segnale mancato da una decisione deliberata e informata. Limitare l’accesso alle valutazioni interne in proporzione alla loro sensibilità, evitando di raccogliere informazioni personali non pertinenti su autori o lettori. Una traccia utile documenta la questione e la decisione; non deve diventare un fascicolo illimitato su tutti i soggetti coinvolti.
Rendere locale la validazione multilingue
Per un team che monitora arabo e inglese, la prima domanda è se la configurazione effettiva supporti la lingua e le fonti previste. L’annuncio esaminato non lo ha stabilito. Chiedere documentazione aggiornata al fornitore e provare il processo rilevante prima di farvi affidamento. Un’interfaccia tradotta, un articolo tradotto e un modello valutato su notizie nella lingua originale sono forme diverse di supporto.
Preparare esempi che riflettano come la copertura locale esprime critica, elogio, incertezza e attribuzione. La stessa frase può avere una forza diversa secondo la testata, il dialetto, le virgolette o l’argomentazione circostante. I revisori dovrebbero spiegare la propria interpretazione in modo chiaro e indicare il passaggio che la sostiene. Una distribuzione delle categorie simile a quella della dashboard inglese non prova prestazioni equivalenti in un’altra lingua.
Riportare la qualità per lingua e tipo di caso quando il campione lo consente. Se gli elementi esaminati sono troppo pochi per una conclusione utile, dirlo. Un piccolo test può individuare modalità di errore senza stimare un tasso stabile. Sono due risultati da tenere separati. Questo è particolarmente importante quando i responsabili chiedono un punteggio globale: una media combinata può nascondere un processo debole in un mercato che merita attenzione specifica.
Aggiungere prove sul pubblico prima di parlare di reputazione
L’analisi della copertura può aiutare a scegliere le domande per una ricerca sul pubblico. Può identificare le affermazioni da verificare e i gruppi potenzialmente rilevanti, ma il disegno della ricerca deve comunque stabilire che cosa le persone abbiano incontrato e che cosa credano. Usare domande coerenti e campioni comparabili per misurare i cambiamenti. Spiegare differenze di tempistica, reclutamento o composizione dei mercati, anziché attribuire ogni movimento alla copertura monitorata.
I riscontri verificati dei clienti possono aggiungere contesto, soprattutto quando fanno esplicito riferimento alla questione. Distinguere pochi commenti informativi da una stima rappresentativa. Reclami sul servizio, cambiamenti negli acquisti e indagini sul brand possono illuminare parti diverse del problema. Non vanno uniti in un’unica storia causale soltanto perché sono cambiati nella stessa settimana. Altri eventi possono spiegare una parte o la totalità della variazione.
Un riepilogo direzionale difendibile può quindi essere prudente e operativo: la copertura di una questione è aumentata; gli articoli esaminati sostengono una preoccupazione specifica; l’impatto sul pubblico resta incerto; il team verifica una domanda definita. Offre una base per agire senza esagerare ciò che si sa. Se ricerche successive sostengono una conclusione più forte, aggiornare la valutazione conservando l’incertezza precedente, invece di riscrivere la storia della decisione.
Avviare un test delimitato e decidere di cosa fidarsi
Cominciare con un insieme definito di brand, mercati, fonti e decisioni. Stabilire il carico manuale attuale, scegliere un campione, concordare i responsabili delle escalation e specificare quando interrompere il test. Misurare il tempo per raggiungere una decisione giustificata, non soltanto quello risparmiato assegnando una categoria. Una classificazione più rapida vale poco se i revisori devono impiegare più tempo per correggere avvisi fuorvianti o cercare il passaggio pertinente.
Alla fine, distinguere le decisioni sostenute dalle prove. Il processo potrebbe essere adatto a ordinare una lista di lettura giornaliera ma non all’escalation automatica delle crisi. Potrebbe funzionare adeguatamente in una lingua e richiedere ulteriori controlli altrove. Documentare questi limiti e riesaminarli quando cambiano fonti, criteri di classificazione o prodotto. La fiducia deve riguardare un caso d’uso verificato, non una generica affermazione secondo cui l’AI comprende la reputazione.
Il valore pratico dell’annuncio NewsWhip è la possibilità di rendere la valutazione della copertura più verificabile e utile. I team dovrebbero giudicarla attraverso i propri esempi esaminati e risultati operativi. Tenere l’etichetta dell’articolo vicina alle prove, rendere esplicita la responsabilità delle azioni e riservare le affermazioni reputazionali alle prove sul pubblico che possono sostenerle.
Commenti
Nessun commento pubblicato.